# 15 millones de servidores web en una sola máquina virtual: por qué el kernel no da para tanto y cómo lo consigue una pila TCP/IP en Rust
- **Publicado el:** 2026-11-22
- **Categoría:** Noticias
- **Página original:** https://linuxgratis.com/articulos/15-millones-servidores-web-una-vm-smoltcp-af-xdp-dpdk
Un experimento de kapteko intenta dar un servidor web a cada habitante del planeta empezando por 15 millones en una VM de 10 GB. Con la red del kernel se queda sin memoria en 2,5 millones; con smoltcp, AF_XDP y DPDK llega a 16 millones. Hemos medido en Linux 7.0 lo que cuesta un socket TCP y probado el truco de AnyIP.
---
¿Cuántos servidores web caben en una máquina virtual con 10 GB de RAM y un solo núcleo? El desarrollador **Artem Yarulin** se lo ha tomado en serio en su blog, [kapteko](https://kapteko.com/15-million-webservers/), con una premisa de broma: si hay tantos ataques contra servidores web es porque hay pocos, así que vamos a dar uno a cada persona del planeta. Para empezar, 15 millones en una sola VM.
La broma es la excusa. Lo interesante es el camino, porque obliga a bajar capa a capa por la red de Linux hasta descubrir dónde se va la memoria, y a acabar sacando la pila TCP/IP del kernel para meterla en el espacio de usuario. El resultado: **con la pila de red del kernel la memoria se agota hacia los 2,5 millones de servidores; con [smoltcp](https://github.com/smoltcp-rs/smoltcp), una pila TCP/IP escrita en Rust, llega a 16 millones**.
Hemos repetido la parte que se puede comprobar en cualquier máquina: cuánto cuesta un socket TCP en el kernel y cómo escuchar en millones de direcciones IP sin tener millones de tarjetas de red.
## Primer muro: los puertos
Un servidor web, visto desde el sistema operativo, es poco más que media docena de llamadas al sistema: `socket`, `listen`, `accept`, `recv`, `send` y `close`. Yarulin empieza con un servidor mínimo en C que pide al kernel un puerto libre cualquiera y responde `OK` a todo. Da unas 65.000 peticiones por segundo. Luego lanza 15 millones en un bucle de shell y el número 28.232 falla.
La explicación está en `net.ipv4.ip_local_port_range`. Cuando un programa no elige puerto, el kernel le asigna uno de ese rango, que por defecto va del 32768 al 60999: 28.232 puertos, justo donde se paró. Aunque se amplíe al rango completo, un puerto es un número de 16 bits y no pasa de 65.535.
La salida es que un servidor no se identifica solo por el puerto, sino por la combinación de protocolo, dirección IP y puerto. Con muchas IP, el mismo puerto 80 vale para todos. Y para tener muchas IP no hacen falta 450 tarjetas de red (la otra broma del artículo): basta con **AnyIP**, una ruta de tipo `local` que hace que el kernel considere propia una subred entera:
```sh
ip -6 route add local 2001:db8:1234:5678::/64 dev lo
```
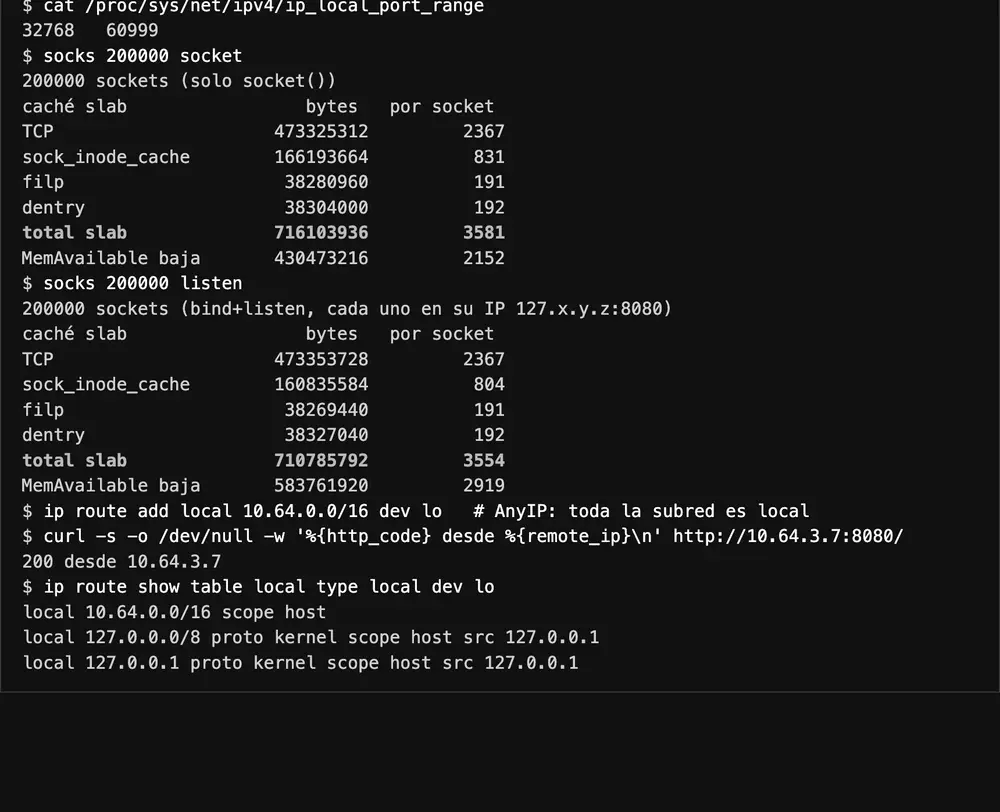
Con un /64 de IPv6, que muchos proveedores dan con cada servidor, hay 18 trillones de direcciones donde escuchar. Lo hemos probado en IPv4 con una /16 privada: tras añadir la ruta, un servidor escuchando en `10.64.3.7`, una dirección que no está asignada a ninguna interfaz, responde sin más. De hecho, Linux ya trae de serie una ruta así para todo `127.0.0.0/8`, y en nuestra prueba abrimos 200.000 sockets escuchando en el puerto 8080, cada uno en su propia dirección `127.x.y.z`.
## Segundo muro: un proceso por servidor
Con las direcciones resueltas, el bucle vuelve a fallar, ahora por falta de memoria. Cada proceso del servidor en C ocupa alrededor de **1,5 MB**, y 15 millones de procesos necesitarían unos 20 TB.
Aquí Yarulin tira de trabajo propio anterior. En vez de procesos, ejecuta todos los servidores como **invitados dentro de un único proceso**, con un entorno de ejecución a medida que los aísla con [LFI](https://www.scs.stanford.edu/~zyedidia/docs/papers/lfi.pdf) (*Lightweight Fault Isolation*, un aislamiento por software de Stanford) y sustituye sus llamadas al sistema por funciones propias. Un planificador en espacio de usuario va saltando de un invitado a otro, y como el servidor solo tiene dos variables de estado (el descriptor que escucha y el del cliente), guardar a cada invitado cuesta unos **16 bytes**: 220 MB para los 15 millones.
## Tercer muro: lo que cuesta un socket en el kernel
Con los procesos fuera de la ecuación, el autor hizo una cuenta optimista: un socket que solo escucha no debería ocupar nada. Se lo preguntó a un asistente de IA, que le dijo que una conexión inactiva cuesta cero bytes, y la cuenta salía. No salía. Un programa que solo llama a `socket()` diez millones de veces agota los 10 GB de la VM.
El propio Yarulin reconoce el error en el artículo, y es la parte más útil: **cada llamada a `socket()` reserva unos 3.300 bytes en el kernel, esté el socket activo, escuchando o sin usar**. Su desglose, con el tamaño de cada estructura:
| Estructura | Tamaño (autor) | Medido por nosotros en la caché slab* | Para qué sirve |
|---|---|---|---|
| `struct tcp_sock` | 2.240 B | 2.366 B (`TCP`) | Estado TCP: colas, temporizadores, números de secuencia, control de congestión |
| `struct socket_alloc` | 768 B | 796-831 B (`sock_inode_cache`) | El `struct socket` con su cola de espera más el inodo de sockfs |
| `struct file` | 184 B | 191 B (`filp`) | El fichero abierto que apunta al socket |
| `struct dentry` | 192 B | 192 B (`dentry`) | El nombre en el pseudosistema de ficheros sockfs |
| **Total** | **3.384 B** | **≈3.550-3.580 B** | |
\* Crecimiento de cada caché dividido entre 200.000 sockets, en Linux 7.0.14. La caché redondea cada objeto por alineación, por eso sale algo más que el `sizeof` de la estructura.
## Lo hemos medido en Linux 7.0
200.000 sockets cuestan unos 710 MB de memoria del kernel, escuchen o no · Captura propia
Repetimos la cuenta en un contenedor Debian 13: 200.000 sockets, primero recién creados y luego escuchando cada uno en su dirección, comparando el tamaño de las cachés del kernel antes y después. Nuestra medida cuadra con la suya: **unos 3,5 KB por socket, y da igual que esté escuchando o no**. Con 10 GB, eso pone el techo teórico en menos de 3 millones de sockets antes de contar nada más. En su prueba, la pila del kernel se quedó sin memoria hacia los 2,55 millones de servidores.
No hay un búfer gordo que recortar, como Yarulin esperaba encontrar. Son estructuras que el kernel necesita para que cualquier socket se comporte como un fichero más y para llevar el estado completo de TCP. Reducirlas supondría reescribir media pila de red.
## La salida: sacar TCP/IP del kernel
Si el problema está en la capa de transporte, la solución pasa por bajar una más. Por debajo de TCP, ni IP ni Ethernet guardan estado: nada impide que un programa construya sus propios paquetes IP o tramas Ethernet si se encarga él mismo de TCP. Es lo que llevan décadas haciendo los sistemas embebidos, y hay donde elegir:
- [lwIP](https://github.com/lwip-tcpip/lwip), la pila en C de tantos microcontroladores.
- [Seastar](https://github.com/scylladb/seastar), el entorno de los creadores de ScyllaDB, con pila propia.
- [gVisor](https://github.com/google/gvisor), que reimplementa buena parte del kernel, red incluida.
- [F-Stack](https://github.com/F-Stack/f-stack), que lleva la pila de FreeBSD al espacio de usuario.
Yarulin eligió **smoltcp**, una pila TCP/IP en Rust con licencia 0BSD pensada para sistemas sin sistema operativo y que no necesita reservar memoria dinámica. Su prueba usa la versión 0.14.0, la última publicada en agosto. smoltcp sabe hablar TCP, pero no mueve paquetes: hay que darle un dispositivo por donde entren y salgan.
## Cuatro formas de mover los paquetes
| Vía | Capa | ¿Quién controla la tarjeta? | Coste | ¿Sigue funcionando SSH? |
|---|---|---|---|---|
| **TUN** | IP (capa 3) | El kernel; interfaz virtual | Una llamada al sistema y una copia por paquete | Sí |
| **TAP** | Ethernet (capa 2) | El kernel; interfaz virtual | Igual que TUN | Sí |
| **AF_XDP** | Ethernet | El kernel, que desvía paquetes con un programa eBPF | Anillos de memoria compartida, sin copias; opcionalmente un núcleo en sondeo continuo | Sí |
| **DPDK** | Ethernet | El programa, en exclusiva | Un núcleo entero en bucle activo | No, si es la misma tarjeta |
smoltcp trae de serie soporte para **TUN y TAP**, las interfaces virtuales del kernel. Son lo más fácil, pero cada paquete sigue pasando por una llamada al sistema y una copia entre el kernel y el programa.
**DPDK** va al otro extremo. El programa habla directamente con la tarjeta a través de búferes en memoria compartida, sin llamadas al sistema y sin interrupciones: un núcleo de la CPU se dedica en exclusiva a mover datos en un bucle infinito. Es lo que usan quienes procesan cientos de millones de paquetes por segundo. A cambio, la tarjeta desaparece para el sistema operativo: ni `ip link` la ve. Si se activa por SSH en la misma interfaz, se pierde la sesión.
**AF_XDP** es el término medio que Linux ofrece desde hace años. La tarjeta sigue en manos del kernel, pero un pequeño programa **eBPF** enganchado a XDP decide para cada paquete si lo entrega directamente en un búfer compartido con el programa, saltándose la pila de red, o lo deja seguir su camino normal. Así se puede desviar el tráfico de los servidores web y que SSH siga funcionando. Con la opción `SO_PREFER_BUSY_POLL` se acerca a DPDK a costa también de un núcleo.
Para conectar smoltcp con estas dos vías basta con implementar su *trait* [`Device`](https://docs.rs/smoltcp/latest/smoltcp/phy/trait.Device.html), o usar los *crates* [xsk-rs](https://github.com/DouglasGray/xsk-rs) para AF_XDP y [rust-dpdk-net](https://github.com/youyuanwu/rust-dpdk-net) para DPDK, que son los que usa la prueba.
## Los resultados
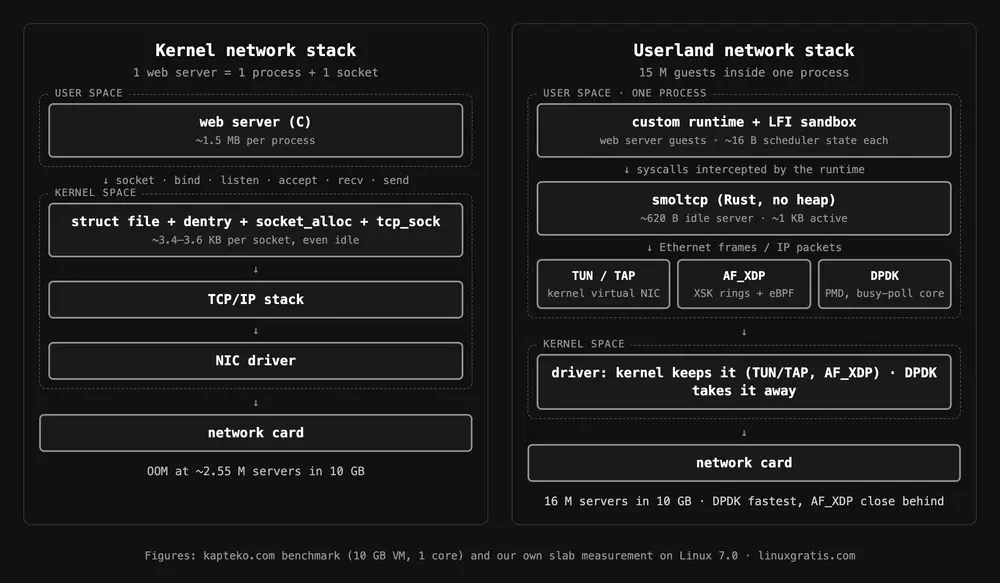
De un socket del kernel por servidor a una pila TCP/IP en Rust dentro de un solo proceso · Esquema propio con cifras de kapteko.com y nuestra medición
El esquema final queda así: el runtime carga los 15 millones de invitados, cada uno se pone a escuchar en su dirección, sus llamadas al sistema van a smoltcp y el planificador despierta al invitado que tiene datos pendientes. Las cifras son las del banco de pruebas del autor:
| Configuración | Coste por servidor | Servidores en la VM de 10 GB |
|---|---|---|
| Un proceso por servidor | ~1,5 MB | ~7.000 (cálculo) |
| Pila de red del kernel | ~3,4 KB por socket + estado del invitado | Sin memoria hacia **2,55 millones** |
| smoltcp | ~620 B inactivo, ~1 KB activo | **16 millones** |
Con la pila del kernel, además, las peticiones por segundo caen a medida que crece el número de servidores. Entre las vías de smoltcp, **DPDK es la más rápida y AF_XDP queda justo detrás**, con la ventaja de no quitarle la tarjeta al sistema. El código está publicado en el [repositorio AI10M](https://github.com/artemyarulin/AI10M/tree/main/poc/ten-million-webservers) del autor.
## Qué sacamos de todo esto
Nadie necesita 15 millones de servidores web en una VM, y el propio autor admite que la prueba de concepto es la parte fácil: un runtime compatible con todas las llamadas POSIX es otra historia. Pero el experimento deja varias cosas útiles para cualquiera que administre servidores Linux:
- **Un socket inactivo no es gratis.** Cada conexión abierta, cada socket en escucha y cada `TIME_WAIT` cuesta del orden de 3,5 KB de memoria del kernel que no aparece en el consumo de ningún proceso. Se ve con `slabtop` o en `/proc/slabinfo` (cachés `TCP`, `sock_inode_cache`, `filp` y `dentry`), y `ss -s` da el recuento.
- **El rango de puertos efímeros es pequeño.** 28.232 puertos por defecto también limitan las conexiones salientes hacia un mismo destino, algo que sufren proxies y balanceadores.
- **AnyIP existe y es muy práctico.** Una ruta `local` permite responder en toda una subred, algo que ya aprovechan algunos balanceadores y CDN para servicios anycast.
- **La red en espacio de usuario no es solo para operadores de bolsa.** Cuando lo que importa es la densidad o la latencia, sacar TCP/IP del kernel da control total sobre la memoria. AF_XDP lo hace accesible sin perder la gestión normal de la máquina.
Y una más, que el autor cuenta sin rodeos: la respuesta del asistente de IA sobre el coste de una conexión inactiva era falsa, y fue la medida la que lo destapó. Rust, por cierto, gana terreno también dentro del propio kernel, como contamos en [Linux 7.4, Rust frente a C](/articulos/linux-7-4-rust-c-ia-arreglos).
## Cómo lo hemos probado
El 22 de noviembre, con Docker en un Mac con Apple Silicon (kernel de la VM de Docker: 7.0.14), en un contenedor `debian:13` privilegiado para poder leer `/proc/slabinfo` y añadir rutas. Compilamos con gcc un programa en C que crea 200.000 sockets TCP (primero solo con `socket()` y luego con `bind()` y `listen()` en el puerto 8080 de direcciones `127.x.y.z` distintas) y compara el tamaño de las cachés slab antes y después. Para AnyIP, añadimos una ruta local y servimos HTTP en una dirección no asignada:
```sh
docker run --rm -it --privileged --ulimit nofile=1048576:1048576 debian:13 bash
apt update && apt install -y gcc libc6-dev iproute2 python3 curl
grep -E '^(TCP|sock_inode_cache|filp|dentry) ' /proc/slabinfo # antes y después de abrir los sockets
ip route add local 10.64.0.0/16 dev lo
python3 -m http.server 8080 --bind 10.64.3.7 &
curl -I http://10.64.3.7:8080/
```
La caída de `MemAvailable` varía bastante entre ejecuciones (entre 2.150 y 2.900 bytes por socket en nuestras pruebas), así que tomamos como referencia el crecimiento de las cachés slab, que fue estable. No hemos repetido el banco de pruebas de 16 millones de servidores: las cifras de smoltcp, AF_XDP y DPDK son las del autor. Al terminar borramos el contenedor y la imagen.
**Fuentes:** [15 million web servers on one VM - smoltcp, DPDK, AF_XDP](https://kapteko.com/15-million-webservers/), de Artem Yarulin en kapteko (18-nov-2026), y su [código de la prueba](https://github.com/artemyarulin/AI10M/tree/main/poc/ten-million-webservers); [smoltcp](https://github.com/smoltcp-rs/smoltcp) y su [documentación del trait Device](https://docs.rs/smoltcp/latest/smoltcp/phy/trait.Device.html); [documentación de AF_XDP](https://docs.kernel.org/networking/af_xdp.html) del kernel; [guías de DPDK](https://doc.dpdk.org/guides/index.html); [ip_local_port_range en la documentación del kernel](https://docs.kernel.org/networking/ip-sysctl.html); [LFI: Lightweight Fault Isolation](https://www.scs.stanford.edu/~zyedidia/docs/papers/lfi.pdf) (Stanford); [xsk-rs](https://github.com/DouglasGray/xsk-rs) y [rust-dpdk-net](https://github.com/youyuanwu/rust-dpdk-net). Consultado el 22-nov-2026.