# Namespaces y cgroups: las piezas del kernel tras los contenedores
- **Publicado el:** 2026-09-18
- **Categoría:** Noticias
- **Página original:** https://linuxgratis.com/articulos/namespaces-y-cgroups-kernel
Descubre cómo los namespaces aíslan procesos y los cgroups limitan recursos en el kernel Linux. La base real de Docker, Kubernetes y systemd, explicada paso a paso.
---
Arrancas un contenedor con Docker o despliegas un pod en Kubernetes y parece magia: un sistema aislado, ligero, con sus propios límites de memoria, que aparece en milisegundos. Magia no hay ninguna. Lo que hay detrás son dos mecanismos del [kernel de Linux](/linux-kernel) que llevan más de una década cociéndose: los **namespaces** y los **cgroups**. Cuando entiendes cómo funcionan te vuelves un administrador bastante más capaz, porque el contenedor deja de ser una caja negra y se convierte en algo que puedes inspeccionar, depurar y ajustar a mano.
## Qué resuelve cada pieza
No conviene mezclarlas, porque hacen cosas distintas que se complementan.
Los **namespaces** controlan *lo que un proceso ve*. Aíslan la vista que un proceso tiene del sistema: qué otros procesos existen, qué interfaces de red hay, qué puntos de montaje aparecen o qué usuarios están definidos. Un proceso dentro de un namespace de PID se cree el PID 1, el proceso de arranque, aunque en el anfitrión sea un PID cualquiera entre miles.
Los **cgroups** (control groups) controlan *cuántos recursos puede consumir* un proceso o un grupo de ellos. Limitan y contabilizan CPU, memoria, ancho de banda de disco y operaciones de entrada/salida. Sin ellos, un solo proceso descontrolado se zamparía toda la RAM y tumbaría la máquina.
Resumiendo: los namespaces dan aislamiento, los cgroups dan límites. Un contenedor no es más que un proceso normal envuelto en una combinación de ambos.
## Los namespaces, uno a uno
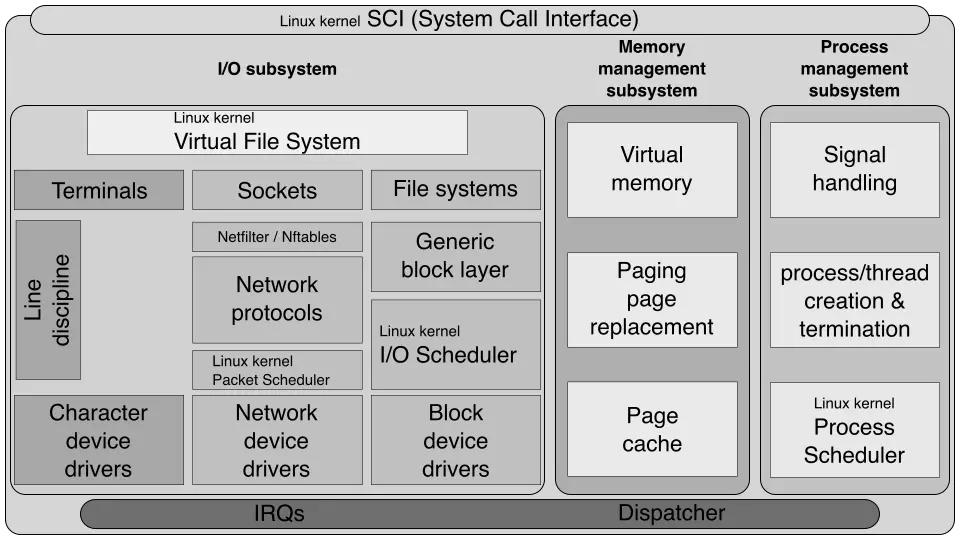
Estructura simplificada del kernel de Linux: los namespaces operan en esta capa del sistema. Diagrama de ScotXW (CC BY-SA 4.0). · Imagen: ScotXW / CC BY-SA 4.0 · Wikimedia Commons
El kernel ofrece hoy ocho tipos de namespaces. Cada uno aísla un aspecto concreto del sistema:
- **PID**: aísla los identificadores de proceso. El primer proceso del namespace se convierte en PID 1.
- **Network (net)**: pila de red independiente, con sus propias direcciones IP, tabla de rutas, sockets y reglas de firewall.
- **Mount (mnt)**: lista propia de puntos de montaje, de modo que puedes montar y desmontar sin afectar al anfitrión.
- **UTS**: aísla el hostname y el nombre de dominio NIS.
- **IPC**: aísla los mecanismos de comunicación entre procesos de tipo System V y las colas de mensajes POSIX.
- **User**: mapea identificadores de usuario, permitiendo ser root (UID 0) dentro del namespace sin serlo en el anfitrión.
- **Cgroup**: ofrece una vista aislada de la jerarquía de cgroups.
- **Time**: permite que un contenedor tenga sus propios relojes monótono y de arranque.
No llegaron todos a la vez. Los namespaces UTS e IPC aparecieron en el kernel 2.6.19 (2006), el de PID se completó en el 2.6.24 (2008), el de red quedó listo hacia el 2.6.29 (2009) y el de usuario se consideró funcional en el kernel 3.8 (2013). El namespace de cgroup llegó en el 4.6 (2016) y el de tiempo, el más nuevo, se fusionó en el kernel 5.6 (marzo de 2020). Aquí hubo evolución a fuego lento, no un gran lanzamiento.
## Los cgroups: límites con historia de Google
Los cgroups nacieron en Google. En 2006 los ingenieros Paul Menage y Rohit Seth empezaron a trabajar en una funcionalidad que por entonces llamaban *process containers*. A finales de 2007 la rebautizaron como *control groups* para evitar confusiones con la palabra "contenedor", y se fusionó en la rama principal del kernel en la versión **2.6.24**, lanzada en enero de 2008.
Aquella primera versión, que hoy conocemos como cgroups v1, permitía múltiples jerarquías independientes para distintos controladores. Funcionaba, pero salía compleja y propensa a inconsistencias. De ahí que apareciera **cgroups v2**, fusionado en el kernel 4.5 (2016), con su *jerarquía unificada*: un único árbol donde todos los controladores conviven de forma coherente. Hoy cgroups v2 viene por defecto en las distribuciones modernas como [Ubuntu](/ubuntu) 22.04 o posterior, [Fedora](/fedora) 31+, [RHEL](/rhel) 9+ y [Debian](/debian) 11+.
## Cómo systemd, Docker y Kubernetes lo usan
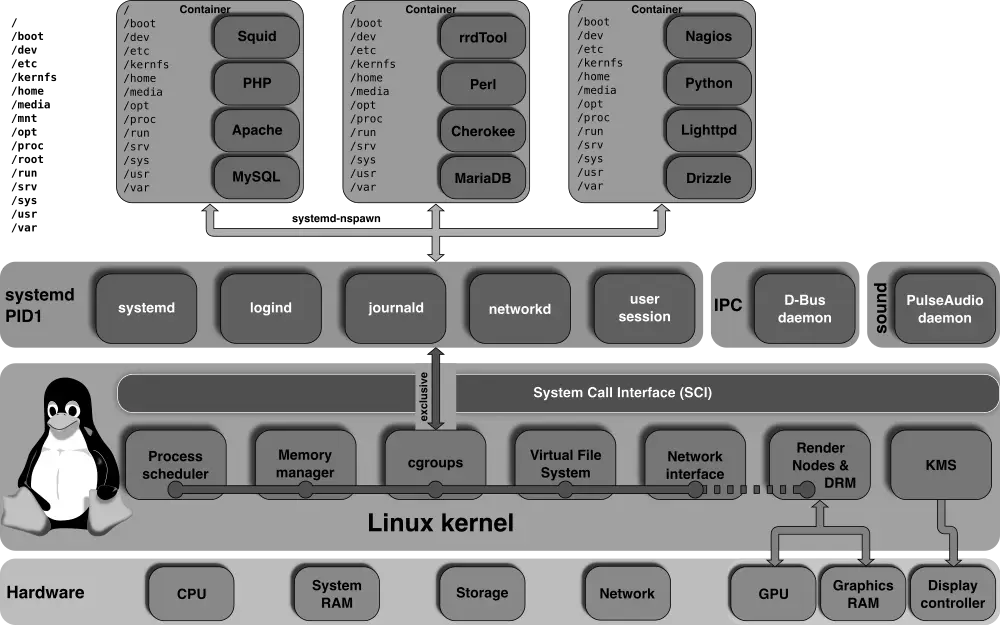
Jerarquía unificada de cgroups y su gestión a través de systemd, la base de los límites de recursos en Docker y Kubernetes. Diagrama de ScotXW (CC BY-SA 3.0). · Imagen: ScotXW / CC BY-SA 3.0 · Wikimedia Commons
Aquí es donde todo encaja. **systemd**, el init de la mayoría de distribuciones, usa cgroups para meter cada servicio en su propia *unit* y aplicarle límites. Cuando defines `MemoryMax` en un servicio, estás escribiendo en un cgroup sin enterarte.
**Docker** combina namespaces (para aislar) con cgroups (para limitar) cada vez que ejecutas `docker run`. Si pasas `--memory` o `--cpus`, estás tocando un cgroup directamente. **Kubernetes** hace lo mismo a escala: cada pod recibe su propio grupo de recursos, y desde la versión 1.25 soporta cgroups v2 de forma estable. De hecho ya ha deprecado cgroups v1.
Distribuciones minimalistas como [Alpine Linux](/alpine-linux), muy socorrida como base de imágenes de contenedor, dependen exactamente de estos mismos mecanismos del kernel. Da igual que el contenedor pese 5 MB o 500 MB: por debajo siempre hay namespaces y cgroups haciendo el trabajo. Y si te tira la virtualización ligera, distribuciones como [Gentoo](/gentoo) o [Arch](/arch) te dejan compilar un kernel a medida y trastear con estas opciones directamente.
## Pruébalo tú mismo
No hace falta Docker para tocar estos mecanismos. El comando `unshare` crea namespaces sobre la marcha: `sudo unshare --pid --fork --mount-proc bash` te mete en un namespace de PID donde tu shell es el PID 1. Para los cgroups, basta con explorar `/sys/fs/cgroup` y mirar la jerarquía de control que tu sistema ya está usando ahora mismo.
Entender namespaces y cgroups no es trivia técnica. Es la diferencia entre fiarte a ciegas de tus contenedores y saber por qué uno se queda sin memoria o por qué dos procesos se ven cuando no deberían. Son las piezas del kernel que sostienen toda la infraestructura moderna, ahí accesibles, esperando a que les eches el guante.