# Namespaces i cgroups: les peces del kernel darrere dels contenidors
- **Publicat el:** 2026-09-18
- **Categoria:** Notícies
- **Pàgina original:** https://linuxgratis.com/ca/articles/namespaces-i-cgroups
Descobreix com els namespaces aïllen processos i els cgroups limiten recursos dins el kernel Linux. La base real de Docker, Kubernetes i systemd, explicada pas a pas.
---
Arrenques un contenidor amb Docker o desplegues un pod a Kubernetes i sembla màgia: un sistema aïllat, lleuger, amb els seus propis límits de memòria, que apareix en mil·lisegons. Màgia no n'hi ha cap. Al darrere hi ha dos mecanismes del [kernel de Linux](/ca/linux-kernel) que fa més d'una dècada que es couen: els **namespaces** i els **cgroups**. Quan entens com funcionen et tornes un administrador força més capaç, perquè el contenidor deixa de ser una caixa negra i passa a ser una cosa que pots inspeccionar, depurar i ajustar a mà.
## Què resol cada peça
No els convé barrejar, perquè fan coses diferents que es complementen.
Els **namespaces** controlen *allò que un procés veu*. Aïllen la visió que un procés té del sistema: quins altres processos existeixen, quines interfícies de xarxa hi ha, quins punts de muntatge apareixen o quins usuaris hi ha definits. Un procés dins d'un namespace de PID es creu que és el PID 1, el procés d'arrencada, encara que a l'amfitrió sigui un PID qualsevol entre milers.
Els **cgroups** (control groups) controlen *quants recursos pot consumir* un procés o un grup d'ells. Limiten i comptabilitzen CPU, memòria, amplada de banda de disc i operacions d'entrada/sortida. Sense ells, un sol procés descontrolat es cruspiria tota la RAM i tombaria la màquina.
Resumint: els namespaces donen aïllament, els cgroups donen límits. Un contenidor no és més que un procés normal embolcallat en una combinació de tots dos.
## Els namespaces, un a un
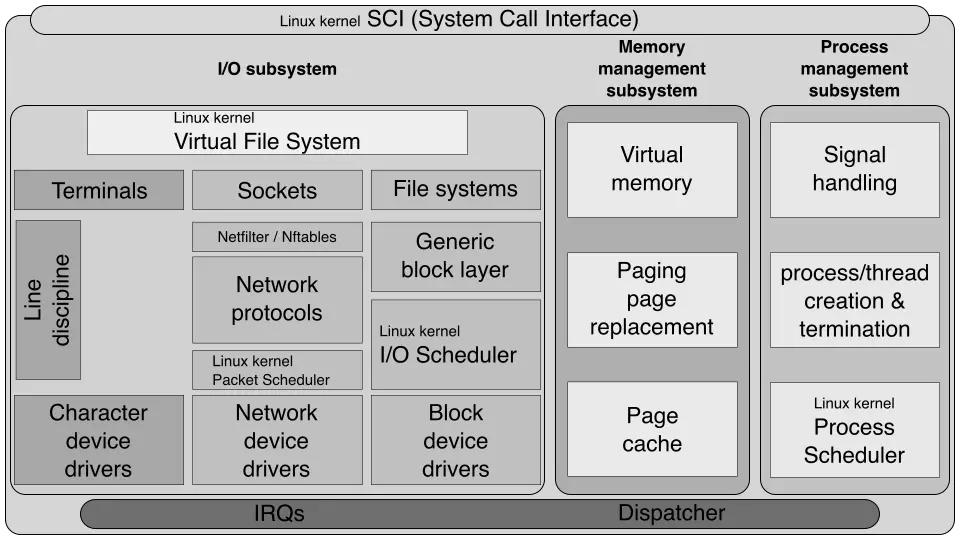
Estructura simplificada del nucli de Linux: els namespaces operen en aquesta capa del sistema. Diagrama de ScotXW (CC BY-SA 4.0). · Imagen: ScotXW / CC BY-SA 4.0 · Wikimedia Commons
El kernel ofereix avui vuit tipus de namespaces. Cadascun aïlla un aspecte concret del sistema:
- **PID**: aïlla els identificadors de procés. El primer procés del namespace es converteix en el PID 1.
- **Network (net)**: pila de xarxa independent, amb les seves pròpies adreces IP, taula de rutes, sockets i regles de tallafocs.
- **Mount (mnt)**: llista pròpia de punts de muntatge, de manera que pots muntar i desmuntar sense afectar l'amfitrió.
- **UTS**: aïlla el hostname i el nom de domini NIS.
- **IPC**: aïlla els mecanismes de comunicació entre processos de tipus System V i les cues de missatges POSIX.
- **User**: mapeja identificadors d'usuari, permetent ser root (UID 0) dins el namespace sense ser-ho a l'amfitrió.
- **Cgroup**: ofereix una visió aïllada de la jerarquia de cgroups.
- **Time**: permet que un contenidor tingui els seus propis rellotges monòton i d'arrencada.
No van arribar tots alhora. Els namespaces UTS i IPC van aparèixer al kernel 2.6.19 (2006), el de PID es va completar al 2.6.24 (2008), el de xarxa va quedar enllestit cap al 2.6.29 (2009) i el d'usuari es va considerar funcional al kernel 3.8 (2013). El namespace de cgroup va arribar al 4.6 (2016) i el de temps, el més nou, es va fusionar al kernel 5.6 (març de 2020). Aquí hi va haver evolució a foc lent, no pas un gran llançament.
## Els cgroups: límits amb història de Google
Els cgroups van néixer a Google. El 2006 els enginyers Paul Menage i Rohit Seth van començar a treballar en una funcionalitat que aleshores anomenaven *process containers*. A finals de 2007 la van rebatejar com *control groups* per evitar confusions amb la paraula "contenidor", i es va fusionar a la branca principal del kernel a la versió **2.6.24**, llançada el gener de 2008.
Aquella primera versió, que avui coneixem com cgroups v1, permetia múltiples jerarquies independents per a controladors diferents. Funcionava, però sortia complexa i propensa a inconsistències. D'aquí que aparegués **cgroups v2**, fusionat al kernel 4.5 (2016), amb la seva *jerarquia unificada*: un únic arbre on tots els controladors conviuen de manera coherent. Avui cgroups v2 ve per defecte a les distribucions modernes com [Ubuntu](/ca/ubuntu) 22.04 o posterior, [Fedora](/ca/fedora) 31+, [RHEL](/ca/rhel) 9+ i [Debian](/ca/debian) 11+.
## Com ho fan servir systemd, Docker i Kubernetes
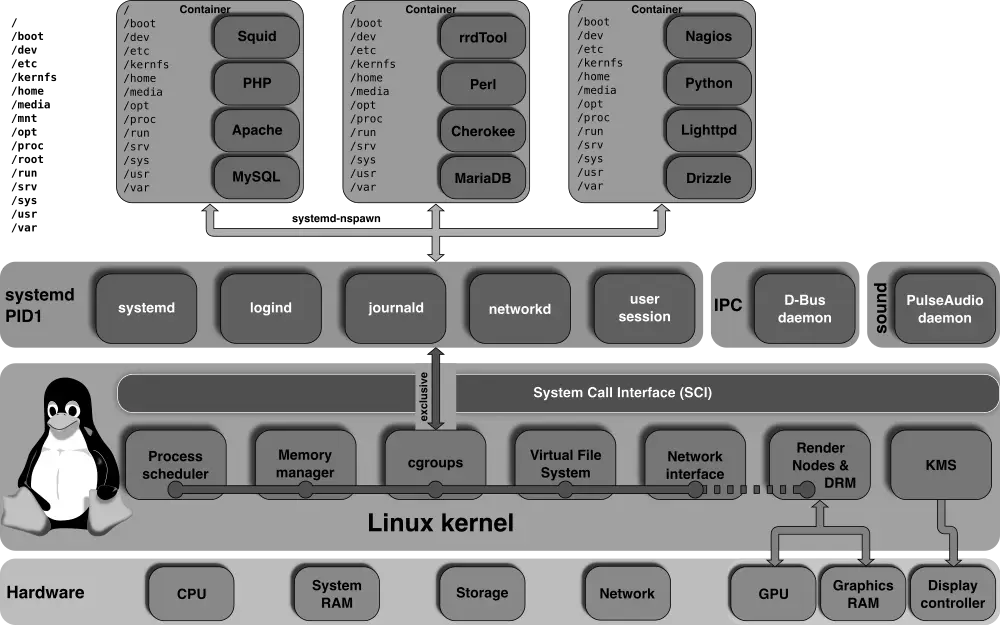
Jerarquia unificada de cgroups i la seva gestió a través de systemd, la base dels límits de recursos a Docker i Kubernetes. Diagrama de ScotXW (CC BY-SA 3.0). · Imagen: ScotXW / CC BY-SA 3.0 · Wikimedia Commons
Aquí és on tot encaixa. **systemd**, l'init de la majoria de distribucions, fa servir cgroups per ficar cada servei en la seva pròpia *unit* i aplicar-li límits. Quan defineixes `MemoryMax` en un servei, estàs escrivint en un cgroup sense adonar-te'n.
**Docker** combina namespaces (per aïllar) amb cgroups (per limitar) cada cop que executes `docker run`. Si passes `--memory` o `--cpus`, estàs tocant un cgroup directament. **Kubernetes** fa el mateix a escala: cada pod rep el seu propi grup de recursos, i des de la versió 1.25 suporta cgroups v2 de manera estable. De fet ja ha deprecat cgroups v1.
Distribucions minimalistes com [Alpine Linux](/ca/alpine-linux), molt socorregudes com a base d'imatges de contenidor, depenen exactament d'aquests mateixos mecanismes del kernel. Tant és si el contenidor pesa 5 MB o 500 MB: per sota sempre hi ha namespaces i cgroups fent la feina. I si et tira la virtualització lleugera, distribucions com [Gentoo](/ca/gentoo) o [Arch](/ca/arch) et deixen compilar un kernel a mida i fer proves amb aquestes opcions directament.
## Prova-ho tu mateix
No et cal Docker per tocar aquests mecanismes. L'ordre `unshare` crea namespaces sobre la marxa: `sudo unshare --pid --fork --mount-proc bash` et fica en un namespace de PID on el teu shell és el PID 1. Per als cgroups, n'hi ha prou amb explorar `/sys/fs/cgroup` i mirar la jerarquia de control que el teu sistema ja està fent servir ara mateix.
Entendre namespaces i cgroups no és cap trivialitat tècnica. És la diferència entre fiar-te a cegues dels teus contenidors i saber per què un es queda sense memòria o per què dos processos es veuen quan no haurien. Són les peces del kernel que sostenen tota la infraestructura moderna, aquí accessibles, esperant que les exploris.