Quants servidors web caben en una màquina virtual amb 10 GB de RAM i un sol nucli? El desenvolupador Artem Yarulin s’ho ha pres seriosament al seu blog, kapteko, amb una premissa de broma: si hi ha tants atacs contra servidors web és perquè n’hi ha pocs, així que donem-ne un a cada persona del planeta. Per començar, 15 milions en una sola VM.
La broma és l’excusa. L’interessant és el camí, perquè obliga a baixar capa a capa per la xarxa de Linux fins a descobrir on se’n va la memòria, i a acabar traient la pila TCP/IP del nucli per posar-la a l’espai d’usuari. El resultat: amb la pila de xarxa del nucli la memòria s’esgota cap als 2,5 milions de servidors; amb smoltcp, una pila TCP/IP escrita en Rust, arriba als 16 milions.
Hem repetit la part que es pot comprovar a qualsevol màquina: quant costa un sòcol TCP al nucli i com escoltar en milions d’adreces IP sense tenir milions de targetes de xarxa.
Primer mur: els ports
Un servidor web, vist des del sistema operatiu, és poc més que mitja dotzena de crides al sistema: socket, listen, accept, recv, send i close. Yarulin comença amb un servidor mínim en C que demana al nucli un port lliure qualsevol i respon OK a tot. Fa unes 65.000 peticions per segon. Després en llança 15 milions en un bucle de shell i el número 28.232 falla.
L’explicació és a net.ipv4.ip_local_port_range. Quan un programa no tria port, el nucli n’hi assigna un d’aquest rang, que per defecte va del 32768 al 60999: 28.232 ports, just on es va aturar. Encara que s’ampliï al rang complet, un port és un número de 16 bits i no passa de 65.535.
La sortida és que un servidor no s’identifica només pel port, sinó per la combinació de protocol, adreça IP i port. Amb moltes IP, el mateix port 80 serveix per a tots. I per tenir moltes IP no calen 450 targetes de xarxa (l’altra broma de l’article): n’hi ha prou amb AnyIP, una ruta de tipus local que fa que el nucli consideri pròpia una subxarxa sencera:
ip -6 route add local 2001:db8:1234:5678::/64 dev loAmb un /64 d’IPv6, que molts proveïdors donen amb cada servidor, hi ha 18 trilions d’adreces on escoltar. Ho hem provat en IPv4 amb una /16 privada: després d’afegir la ruta, un servidor que escolta a 10.64.3.7, una adreça que no està assignada a cap interfície, respon sense més. De fet, Linux ja porta de sèrie una ruta així per a tot 127.0.0.0/8, i a la nostra prova vam obrir 200.000 sòcols escoltant al port 8080, cadascun a la seva pròpia adreça 127.x.y.z.
Segon mur: un procés per servidor
Amb les adreces resoltes, el bucle torna a fallar, ara per falta de memòria. Cada procés del servidor en C ocupa al voltant d’1,5 MB, i 15 milions de processos necessitarien uns 20 TB.
Aquí Yarulin tira de feina pròpia anterior. En lloc de processos, executa tots els servidors com a convidats dins d’un únic procés, amb un entorn d’execució a mida que els aïlla amb LFI (Lightweight Fault Isolation, un aïllament per programari de Stanford) i substitueix les seves crides al sistema per funcions pròpies. Un planificador a l’espai d’usuari va saltant d’un convidat a un altre, i com que el servidor només té dues variables d’estat (el descriptor que escolta i el del client), desar cada convidat costa uns 16 bytes: 220 MB per als 15 milions.
Tercer mur: el que costa un sòcol al nucli
Amb els processos fora de l’equació, l’autor va fer un càlcul optimista: un sòcol que només escolta no hauria d’ocupar res. Ho va preguntar a un assistent d’IA, que li va dir que una connexió inactiva costa zero bytes, i el compte sortia. No sortia. Un programa que només crida socket() deu milions de vegades esgota els 10 GB de la VM.
El mateix Yarulin reconeix l’error a l’article, i és la part més útil: cada crida a socket() reserva uns 3.300 bytes al nucli, tant si el sòcol és actiu com si escolta o no s’usa. El seu desglossament, amb la mida de cada estructura:
| Estructura | Mida (autor) | Mesurat per nosaltres a la memòria cau slab* | Per a què serveix |
|---|---|---|---|
struct tcp_sock |
2.240 B | 2.366 B (TCP) |
Estat TCP: cues, temporitzadors, números de seqüència, control de congestió |
struct socket_alloc |
768 B | 796-831 B (sock_inode_cache) |
El struct socket amb la seva cua d’espera més l’inode de sockfs |
struct file |
184 B | 191 B (filp) |
El fitxer obert que apunta al sòcol |
struct dentry |
192 B | 192 B (dentry) |
El nom al pseudosistema de fitxers sockfs |
| Total | 3.384 B | ≈3.550-3.580 B |
* Creixement de cada memòria cau dividit entre 200.000 sòcols, a Linux 7.0.14. La memòria cau arrodoneix cada objecte per alineació, per això surt una mica més que el sizeof de l’estructura.
Ho hem mesurat a Linux 7.0
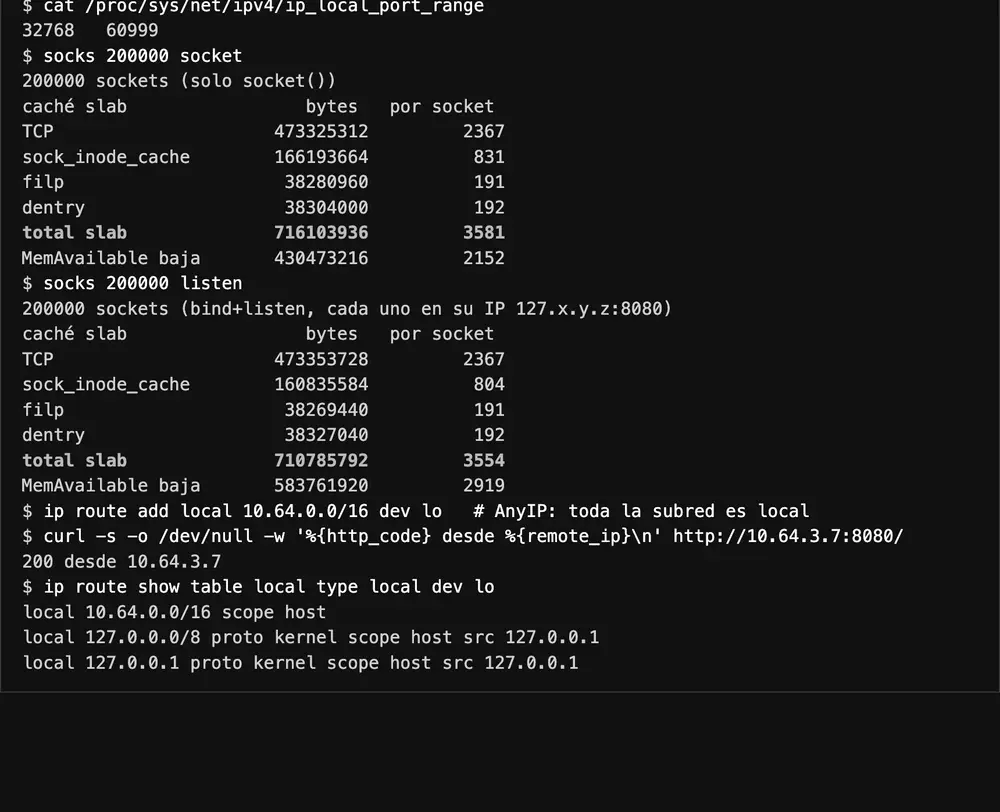
Vam repetir el compte en un contenidor Debian 13: 200.000 sòcols, primer acabats de crear i després escoltant cadascun a la seva adreça, comparant la mida de les memòries cau del nucli abans i després. La nostra mesura quadra amb la seva: uns 3,5 KB per sòcol, i tant és que estigui escoltant o no. Amb 10 GB, això posa el sostre teòric per sota dels 3 milions de sòcols abans de comptar res més. A la seva prova, la pila del nucli es va quedar sense memòria cap als 2,55 milions de servidors.
No hi ha cap memòria intermèdia grossa per retallar, com Yarulin esperava trobar. Són estructures que el nucli necessita perquè qualsevol sòcol es comporti com un fitxer més i per portar l’estat complet de TCP. Reduir-les suposaria reescriure mitja pila de xarxa.
La sortida: treure TCP/IP del nucli
Si el problema és a la capa de transport, la solució passa per baixar-ne una més. Per sota de TCP, ni IP ni Ethernet guarden estat: res no impedeix que un programa construeixi els seus propis paquets IP o trames Ethernet si s’encarrega ell mateix de TCP. És el que fan des de fa dècades els sistemes encastats, i hi ha on triar:
- lwIP, la pila en C de tants microcontroladors.
- Seastar, l’entorn dels creadors de ScyllaDB, amb pila pròpia.
- gVisor, que reimplementa bona part del nucli, xarxa inclosa.
- F-Stack, que porta la pila de FreeBSD a l’espai d’usuari.
Yarulin va triar smoltcp, una pila TCP/IP en Rust amb llicència 0BSD pensada per a sistemes sense sistema operatiu i que no necessita reservar memòria dinàmica. La seva prova fa servir la versió 0.14.0, l’última, publicada a l’agost. smoltcp sap parlar TCP, però no mou paquets: cal donar-li un dispositiu per on entrin i surtin.
Quatre maneres de moure els paquets
| Via | Capa | Qui controla la targeta? | Cost | Continua funcionant SSH? |
|---|---|---|---|---|
| TUN | IP (capa 3) | El nucli; interfície virtual | Una crida al sistema i una còpia per paquet | Sí |
| TAP | Ethernet (capa 2) | El nucli; interfície virtual | Igual que TUN | Sí |
| AF_XDP | Ethernet | El nucli, que desvia paquets amb un programa eBPF | Anells de memòria compartida, sense còpies; opcionalment un nucli de CPU en sondeig continu | Sí |
| DPDK | Ethernet | El programa, en exclusiva | Un nucli de CPU sencer en bucle actiu | No, si és la mateixa targeta |
smoltcp porta de sèrie suport per a TUN i TAP, les interfícies virtuals del nucli. Són el més fàcil, però cada paquet continua passant per una crida al sistema i una còpia entre el nucli i el programa.
DPDK és a l’altre extrem. El programa parla directament amb la targeta a través de memòries intermèdies compartides, sense crides al sistema i sense interrupcions: un nucli de la CPU es dedica en exclusiva a moure dades en un bucle infinit. És el que fan servir els qui processen centenars de milions de paquets per segon. A canvi, la targeta desapareix per al sistema operatiu: ni ip link la veu. Si s’activa per SSH a la mateixa interfície, es perd la sessió.
AF_XDP és el terme mitjà que Linux ofereix des de fa anys. La targeta continua en mans del nucli, però un petit programa eBPF enganxat a XDP decideix per a cada paquet si el lliura directament a una memòria compartida amb el programa, saltant-se la pila de xarxa, o el deixa seguir el seu camí normal. Així es pot desviar el trànsit dels servidors web i que SSH continuï funcionant. Amb l’opció SO_PREFER_BUSY_POLL s’acosta a DPDK, també a costa d’un nucli de CPU.
Per connectar smoltcp amb aquestes dues vies n’hi ha prou d’implementar el seu trait Device, o fer servir els crates xsk-rs per a AF_XDP i rust-dpdk-net per a DPDK, que són els que fa servir la prova.
Els resultats
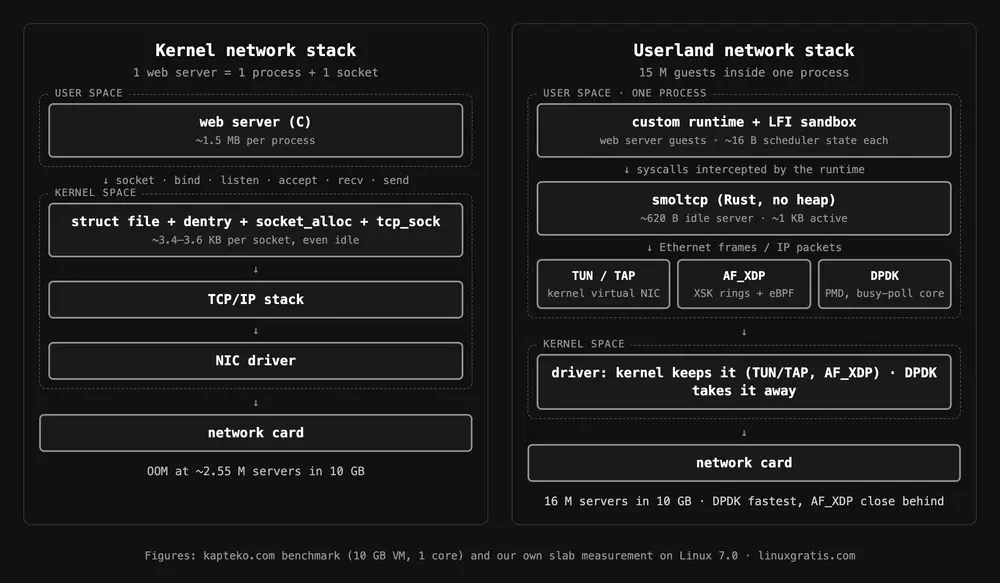
L’esquema final queda així: l’entorn d’execució carrega els 15 milions de convidats, cadascun es posa a escoltar a la seva adreça, les seves crides al sistema van a smoltcp i el planificador desperta el convidat que té dades pendents. Les xifres són les del banc de proves de l’autor:
| Configuració | Cost per servidor | Servidors a la VM de 10 GB |
|---|---|---|
| Un procés per servidor | ~1,5 MB | ~7.000 (càlcul) |
| Pila de xarxa del nucli | ~3,4 KB per sòcol + estat del convidat | Sense memòria cap als 2,55 milions |
| smoltcp | ~620 B inactiu, ~1 KB actiu | 16 milions |
Amb la pila del nucli, a més, les peticions per segon cauen a mesura que creix el nombre de servidors. Entre les vies de smoltcp, DPDK és la més ràpida i AF_XDP queda just darrere, amb l’avantatge de no prendre la targeta al sistema. El codi està publicat al repositori AI10M de l’autor.
Què en traiem
Ningú no necessita 15 milions de servidors web en una VM, i el mateix autor admet que la prova de concepte és la part fàcil: un entorn compatible amb totes les crides POSIX és una altra història. Però l’experiment deixa diverses coses útils per a qualsevol que administri servidors Linux:
- Un sòcol inactiu no és gratis. Cada connexió oberta, cada sòcol en escolta i cada
TIME_WAITcosta de l’ordre de 3,5 KB de memòria del nucli que no apareix en el consum de cap procés. Es veu ambslabtopo a/proc/slabinfo(memòries cauTCP,sock_inode_cache,filpidentry), iss -sen dona el recompte. - El rang de ports efímers és petit. Els 28.232 ports per defecte també limiten les connexions sortints cap a una mateixa destinació, cosa que pateixen servidors intermediaris i balancejadors.
- AnyIP existeix i és molt pràctic. Una ruta
localpermet respondre en tota una subxarxa, cosa que ja aprofiten alguns balancejadors i CDN per a serveis anycast. - La xarxa a l’espai d’usuari no és només per als operadors de borsa. Quan el que importa és la densitat o la latència, treure TCP/IP del nucli dona control total sobre la memòria. AF_XDP ho fa accessible sense perdre la gestió normal de la màquina.
I una més, que l’autor explica sense embuts: la resposta de l’assistent d’IA sobre el cost d’una connexió inactiva era falsa, i va ser la mesura la que ho va destapar. Rust, per cert, també guanya terreny dins del mateix nucli, com vam explicar a Linux 7.4, Rust davant de C.
Com ho hem provat
El 22 de novembre, amb Docker en un Mac amb Apple Silicon (nucli de la VM de Docker: 7.0.14), en un contenidor debian:13 privilegiat per poder llegir /proc/slabinfo i afegir rutes. Vam compilar amb gcc un programa en C que crea 200.000 sòcols TCP (primer només amb socket() i després amb bind() i listen() al port 8080 d’adreces 127.x.y.z diferents) i compara la mida de les memòries cau slab abans i després. Per a AnyIP, vam afegir una ruta local i vam servir HTTP en una adreça no assignada:
docker run --rm -it --privileged --ulimit nofile=1048576:1048576 debian:13 bash
apt update && apt install -y gcc libc6-dev iproute2 python3 curl
grep -E '^(TCP|sock_inode_cache|filp|dentry) ' /proc/slabinfo   # abans i després d'obrir els sòcols
ip route add local 10.64.0.0/16 dev lo
python3 -m http.server 8080 --bind 10.64.3.7 &
curl -I http://10.64.3.7:8080/
La baixada de MemAvailable varia força entre execucions (entre 2.150 i 2.900 bytes per sòcol a les nostres proves), així que vam prendre com a referència el creixement de les memòries cau slab, que va ser estable. No hem repetit el banc de proves de 16 milions de servidors: les xifres de smoltcp, AF_XDP i DPDK són les de l’autor. En acabar vam esborrar el contenidor i la imatge.
Fonts: 15 million web servers on one VM - smoltcp, DPDK, AF_XDP, d’Artem Yarulin a kapteko (18-nov-2026), i el seu codi de la prova; smoltcp i la seva documentació del trait Device; documentació d’AF_XDP del nucli; guies de DPDK; ip_local_port_range a la documentació del nucli; LFI: Lightweight Fault Isolation (Stanford); xsk-rs i rust-dpdk-net. Consultat el 22-nov-2026.